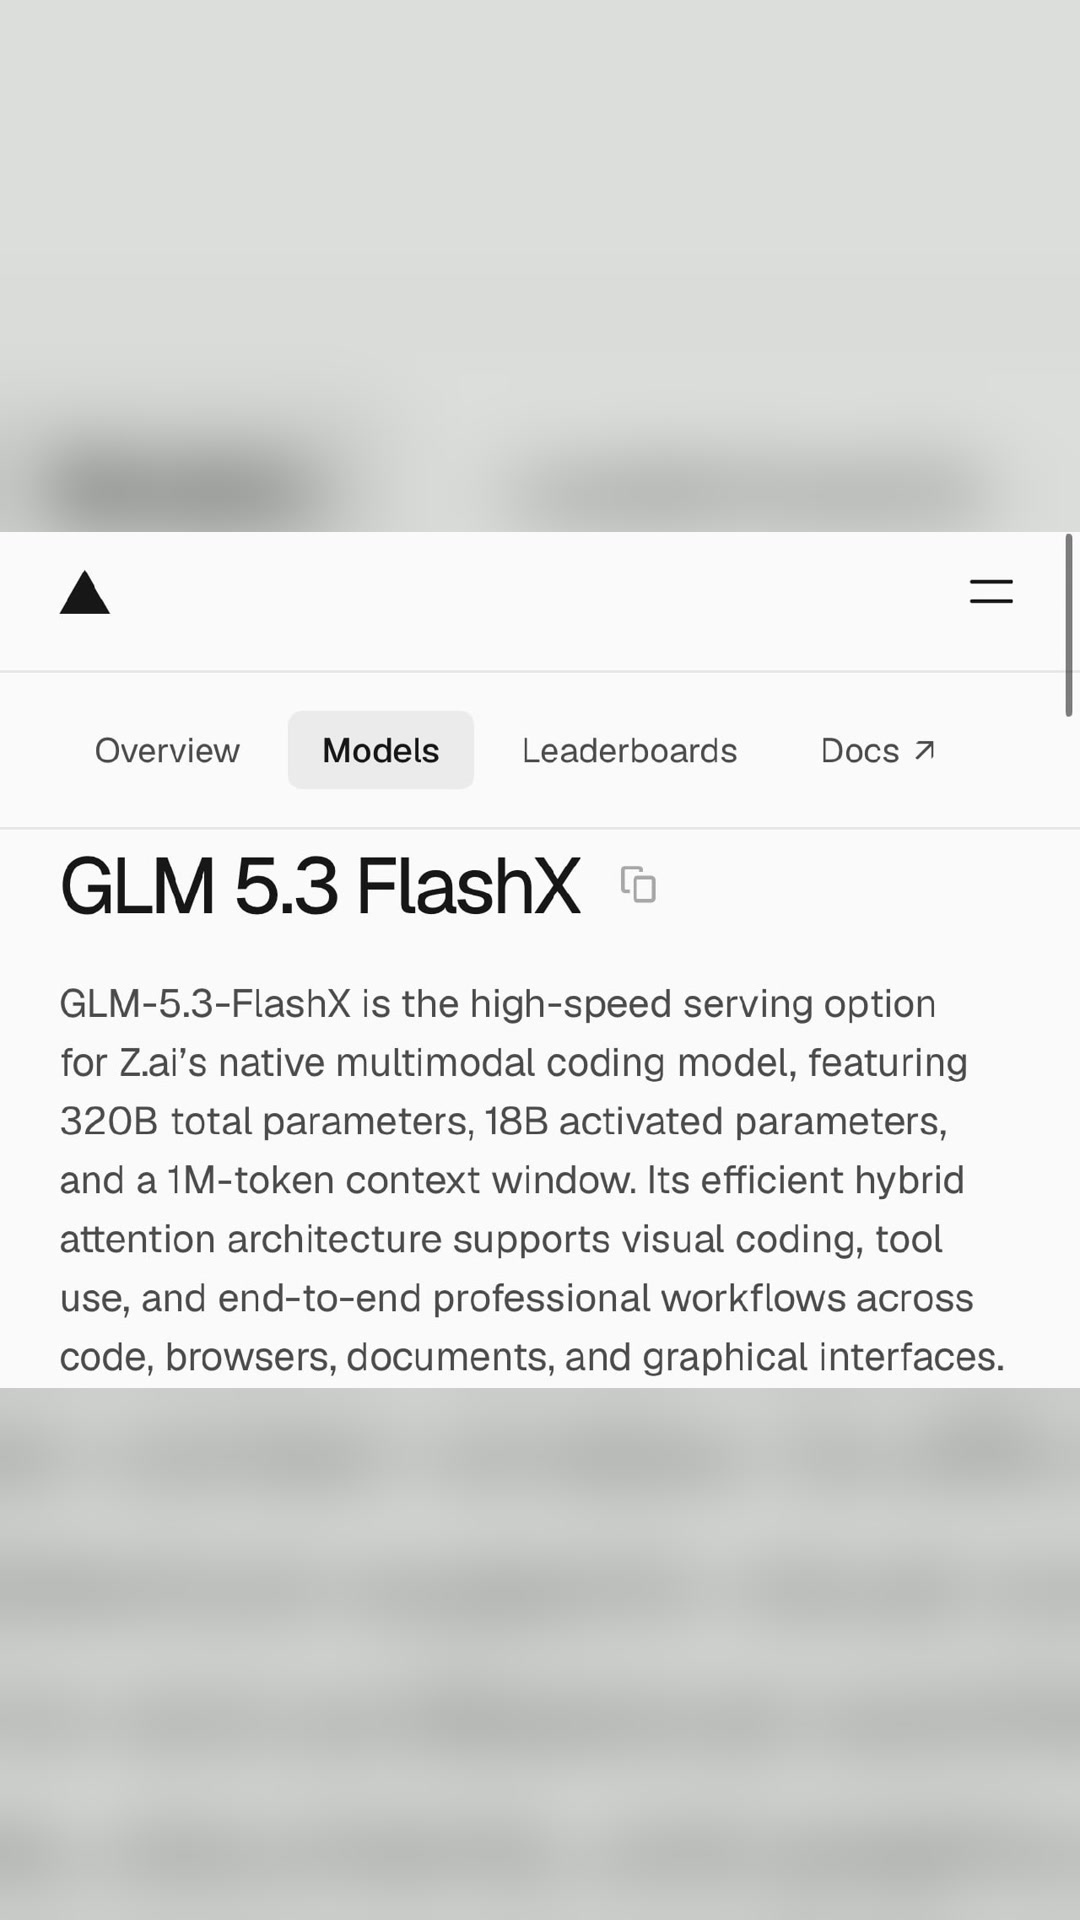
🚨 Z.ai launches GLM 5.3 FlashX at up to 200 tokens/s
🚨 Z.ai launches GLM 5.3 FlashX at up to 200 tokens/s
It is essentially the same 320B GLM 5.3 Flash, but with a heavily optimized inference stack and up to 5× faster generation.
Runs on 100,000+ Chinese AI chips. API costs 2.5× more than Flash.