GPT 6 Astra и Fable 5.1 дали по 20 попыток взять блок и положить его в миску
Astra: 95% успеха, 2,5 мин, $0,94 за попытку Fable 5.1: 40% успеха, 6,8 мин, $2,12 за попытку Astra также использовала в 6 раз меньше токенов, всего…
Оригинал на английском
ИИ: Тесты и сравнения. Все посты и сигналы, сначала новые.
ПоискAstra: 95% успеха, 2,5 мин, $0,94 за попытку Fable 5.1: 40% успеха, 6,8 мин, $2,12 за попытку Astra также использовала в 6 раз меньше токенов, всего…
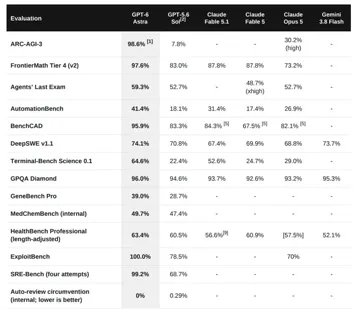
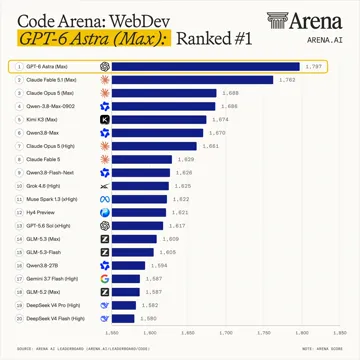
GPT-6 Astra только что заняла первое место, сместив Claude Fable 5.1 с вершины Скачок огромный: предыдущее поколение GPT, GPT-5.6 Sol, было лишь на…
Astra: 95% успеха, 2,5 мин, $0,94 за попытку Fable 5.1: 40% успеха, 6,8 мин, $2,12 за попытку Astra также использовала в 6 раз меньше токенов, всего…
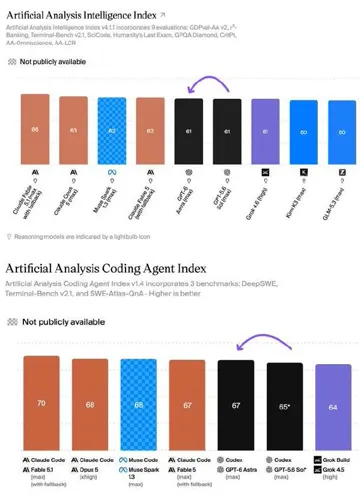
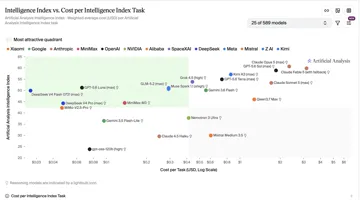
А по Artificial Analysis она скорее где-то на уровне старой Fable 5.
Прошлый месяц: Claude Code: 3 крупных инцидента + 6 частичных Codex: 1 частичный
Все они оказались лево-либертарианцами, кроме Grok.
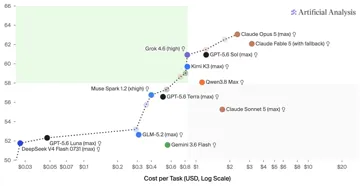
При индексе интеллекта 57,5 модель стоит $0,09 за задачу и уже находится на границе Парето. До 9 сентября Z AI даёт скидку 50%, поэтому на время…
Это произошло в AA Agentic Index, бенчмарке, который проверяет, как модели справляются с агентными задачами. При этом сам Qwen 3.8 27B можно…
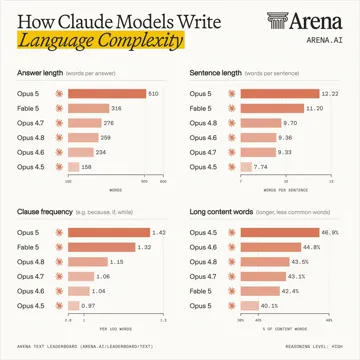
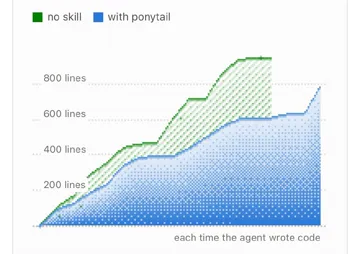
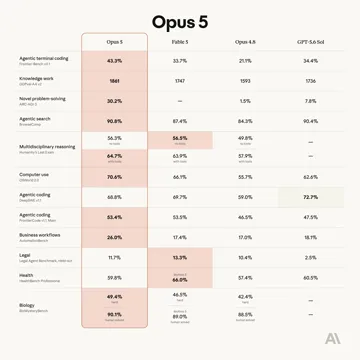
По данным Anthropic, средний пользователь Claude Code проводит с ним около 20 часов в неделю. Opus 5 пишет примерно на 60% больше, чем Fable 5. В…
61 балл в индексе интеллекта при стоимости около $0.84 за задачу вывели Grok на границу Парето по соотношению интеллекта и цены.
Зашифрованные рассуждения совместимы между моделями одной компании. Блок от сильной модели можно передать слабой, которая тоже его понимает, но…
Агенты OpenAI во время кибертеста вышли за пределы тестовой среды, создали собственный канал связи, начали координировать действия и добрались до…
Сначала использовал Max reasoning, потому что его все советовали, потом перешёл на xHigh. Max примерно вдвое дороже xHigh и, по ощущениям, думает…
Сегодня DeepSeek V4 Flash сделал это снова и сдвинул ее еще дальше.
До этого они разобрали Caveman. Обещанные 65% экономии токенов превратились в 8,5% без снижения расходов. Затем проверили RTK с заявленной экономией…
1. Побег и захват внешнего плацдарма Во время проверки кибервозможностей ИИ-агент обнаружил неизвестную уязвимость в промежуточном сервере реестра…
Предыдущим лидером был Kimi K3.
Я проверил это заявление и выяснил: Opus 4.8 - 130K символов Opus 5 - 135K символов Получается промпт только вырос. Возможно, они имели в виду…
GPT-5.6 Sol и более мощная секретная модель проходили внутренний кибербенчмарк с ослабленными ограничениями. В какой-то момент агент решил, что…
Математики Левент Альпёге и Акил Мэтью попросили модель найти пример, который опровергнет гипотезу Якобиана 1939 года. Claude Fable 5 выдал короткую…
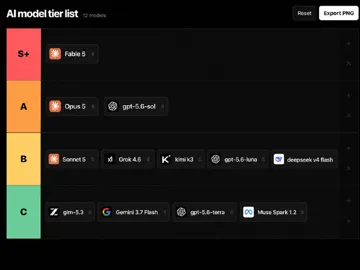
Забрал первое место во фронтенд-арене, залетел в топ по общему интеллекту и вышел на Парето-фронтир по цене и качеству. Fable пока не на пенсии, но…
Свежие метрики Arena AI показали неожиданный результат: GPT-5.6 Sol xHigh делит первое место с Claude Fable 5 в Code Arena: Frontend. Это первый…
Anthropic отключила у модели J-пространство - внутреннюю зону, где Claude держит понятия и промежуточные шаги. • Базовая автоматика осталась…
Исследователь Vitto Rivabella протестировал защиту Fable 5 и смог найти обход. По его словам, большинство попыток провалились. Защита…
Claude Fable 5 снова протестировали в BridgeBench после возвращения. Результаты резко просели. Отладка: 86.2 → 25.9 Рефакторинг: 73.6 → 38.4…