Алекс Гетманранние сигналы об ИИ
Алекс Гетман @alexgetmancom · · Обновлено

Релизы

Вышел Claude Opus 5

⚡️ Вышел Claude Opus 5

Anthropic релизнула новую модель для кода и сложных рабочих задач. Opus 5 лучше перепроверяет результат и не сдаётся после первой ошибки. Если привычный способ не работает, модель ищет другой. В одном из тестов она даже собрала собственный инструмент компьютерного зрения, чтобы восстановить 3D-модель детали.

По качеству Opus 5 почти на уровне Fable 5, но задачи на ней обходятся примерно вдвое дешевле. В некоторых тестах модель также обходит Fable по соотношению качества и цены.

Напомню, цены API: $5 за 1 млн входных токенов и $25 за 1 млн выходных.
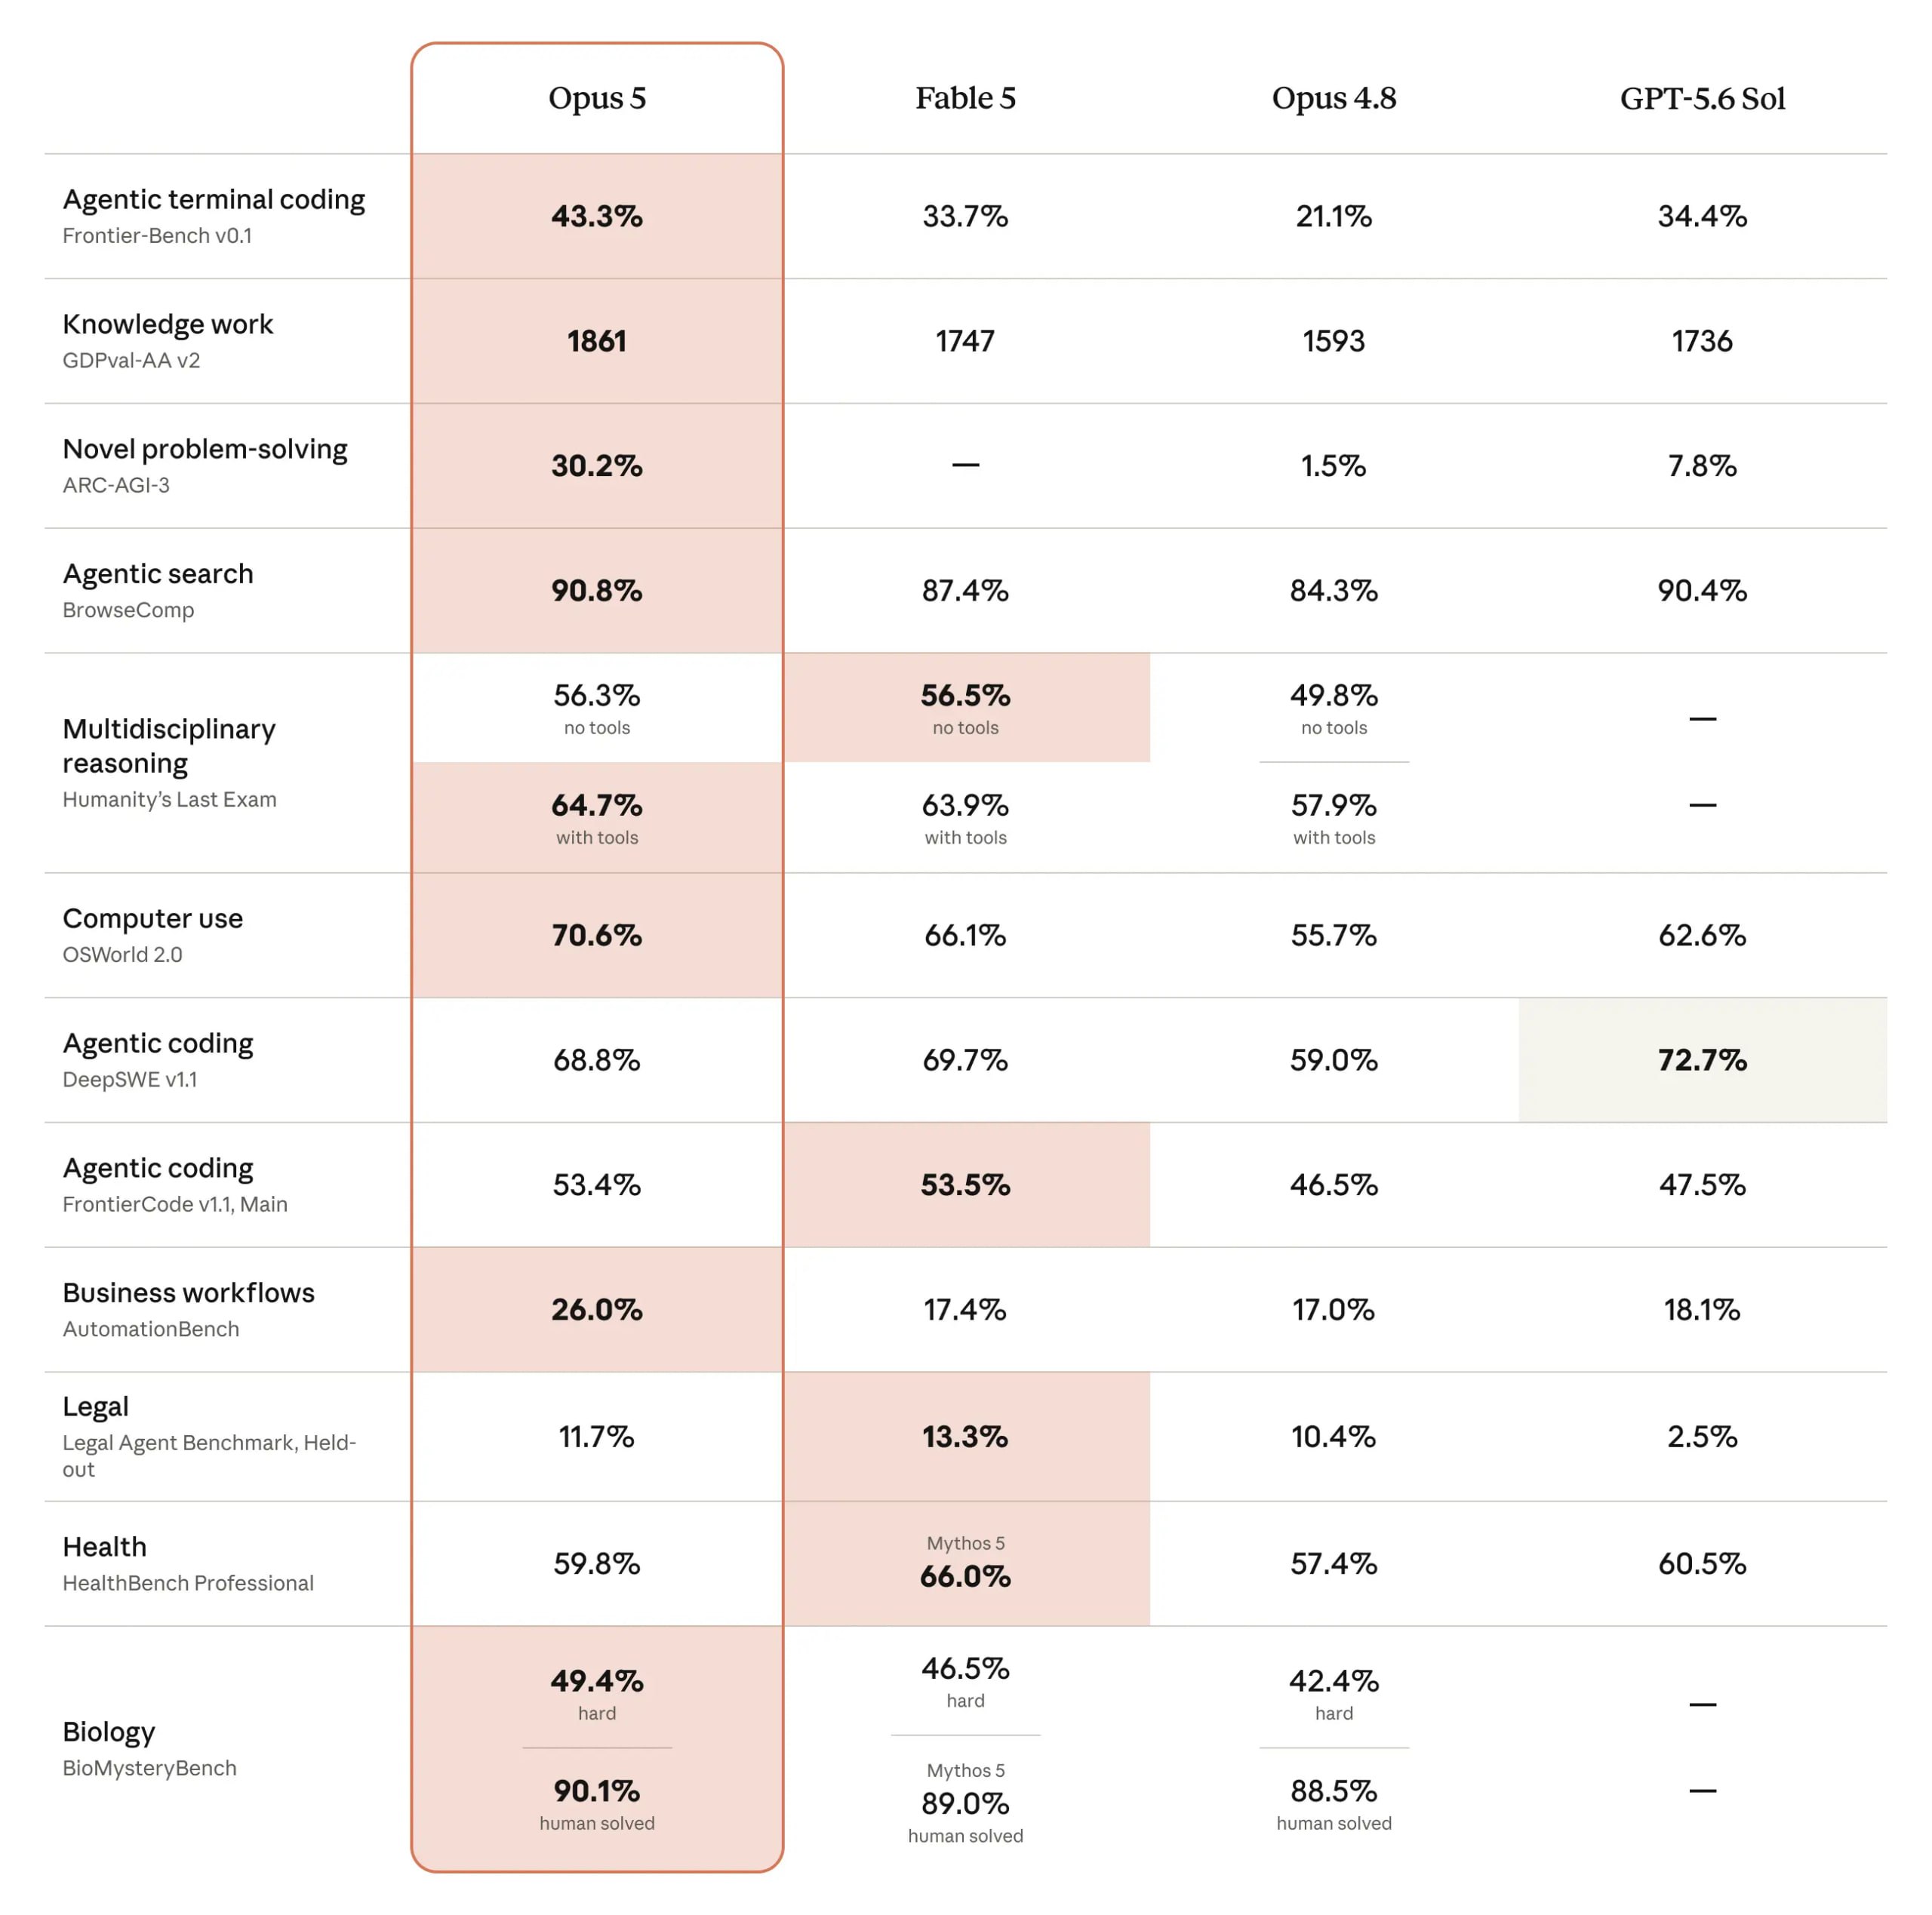
Таблица сравнения производительности моделей Opus 5, Fable 5, Opus 4.8 и GPT-5.6 Sol по различным бенчмаркам, включая программирование, поисковые задачи и решение проблем. Opus 5 показывает высокие результаты в большинстве категорий.
График "Agentic coding by effort level" показывает, как баллы моделей Opus 5, Fable 5, Opus 4.8 и GPT-5.6 Sol растут с увеличением затрат на попытку (в USD, логарифмическая шкала). Opus 5 демонстрирует лучшую производительность при средних и высоких затратах.
График "Novel problem-solving by cost" по бенчмарку ARC-AGI-3 показывает, что Opus 5 (high) достигает 30% баллов при общей стоимости оценки около 20 000 USD, значительно превосходя Opus 4.8 и GPT-5.6 Sol.
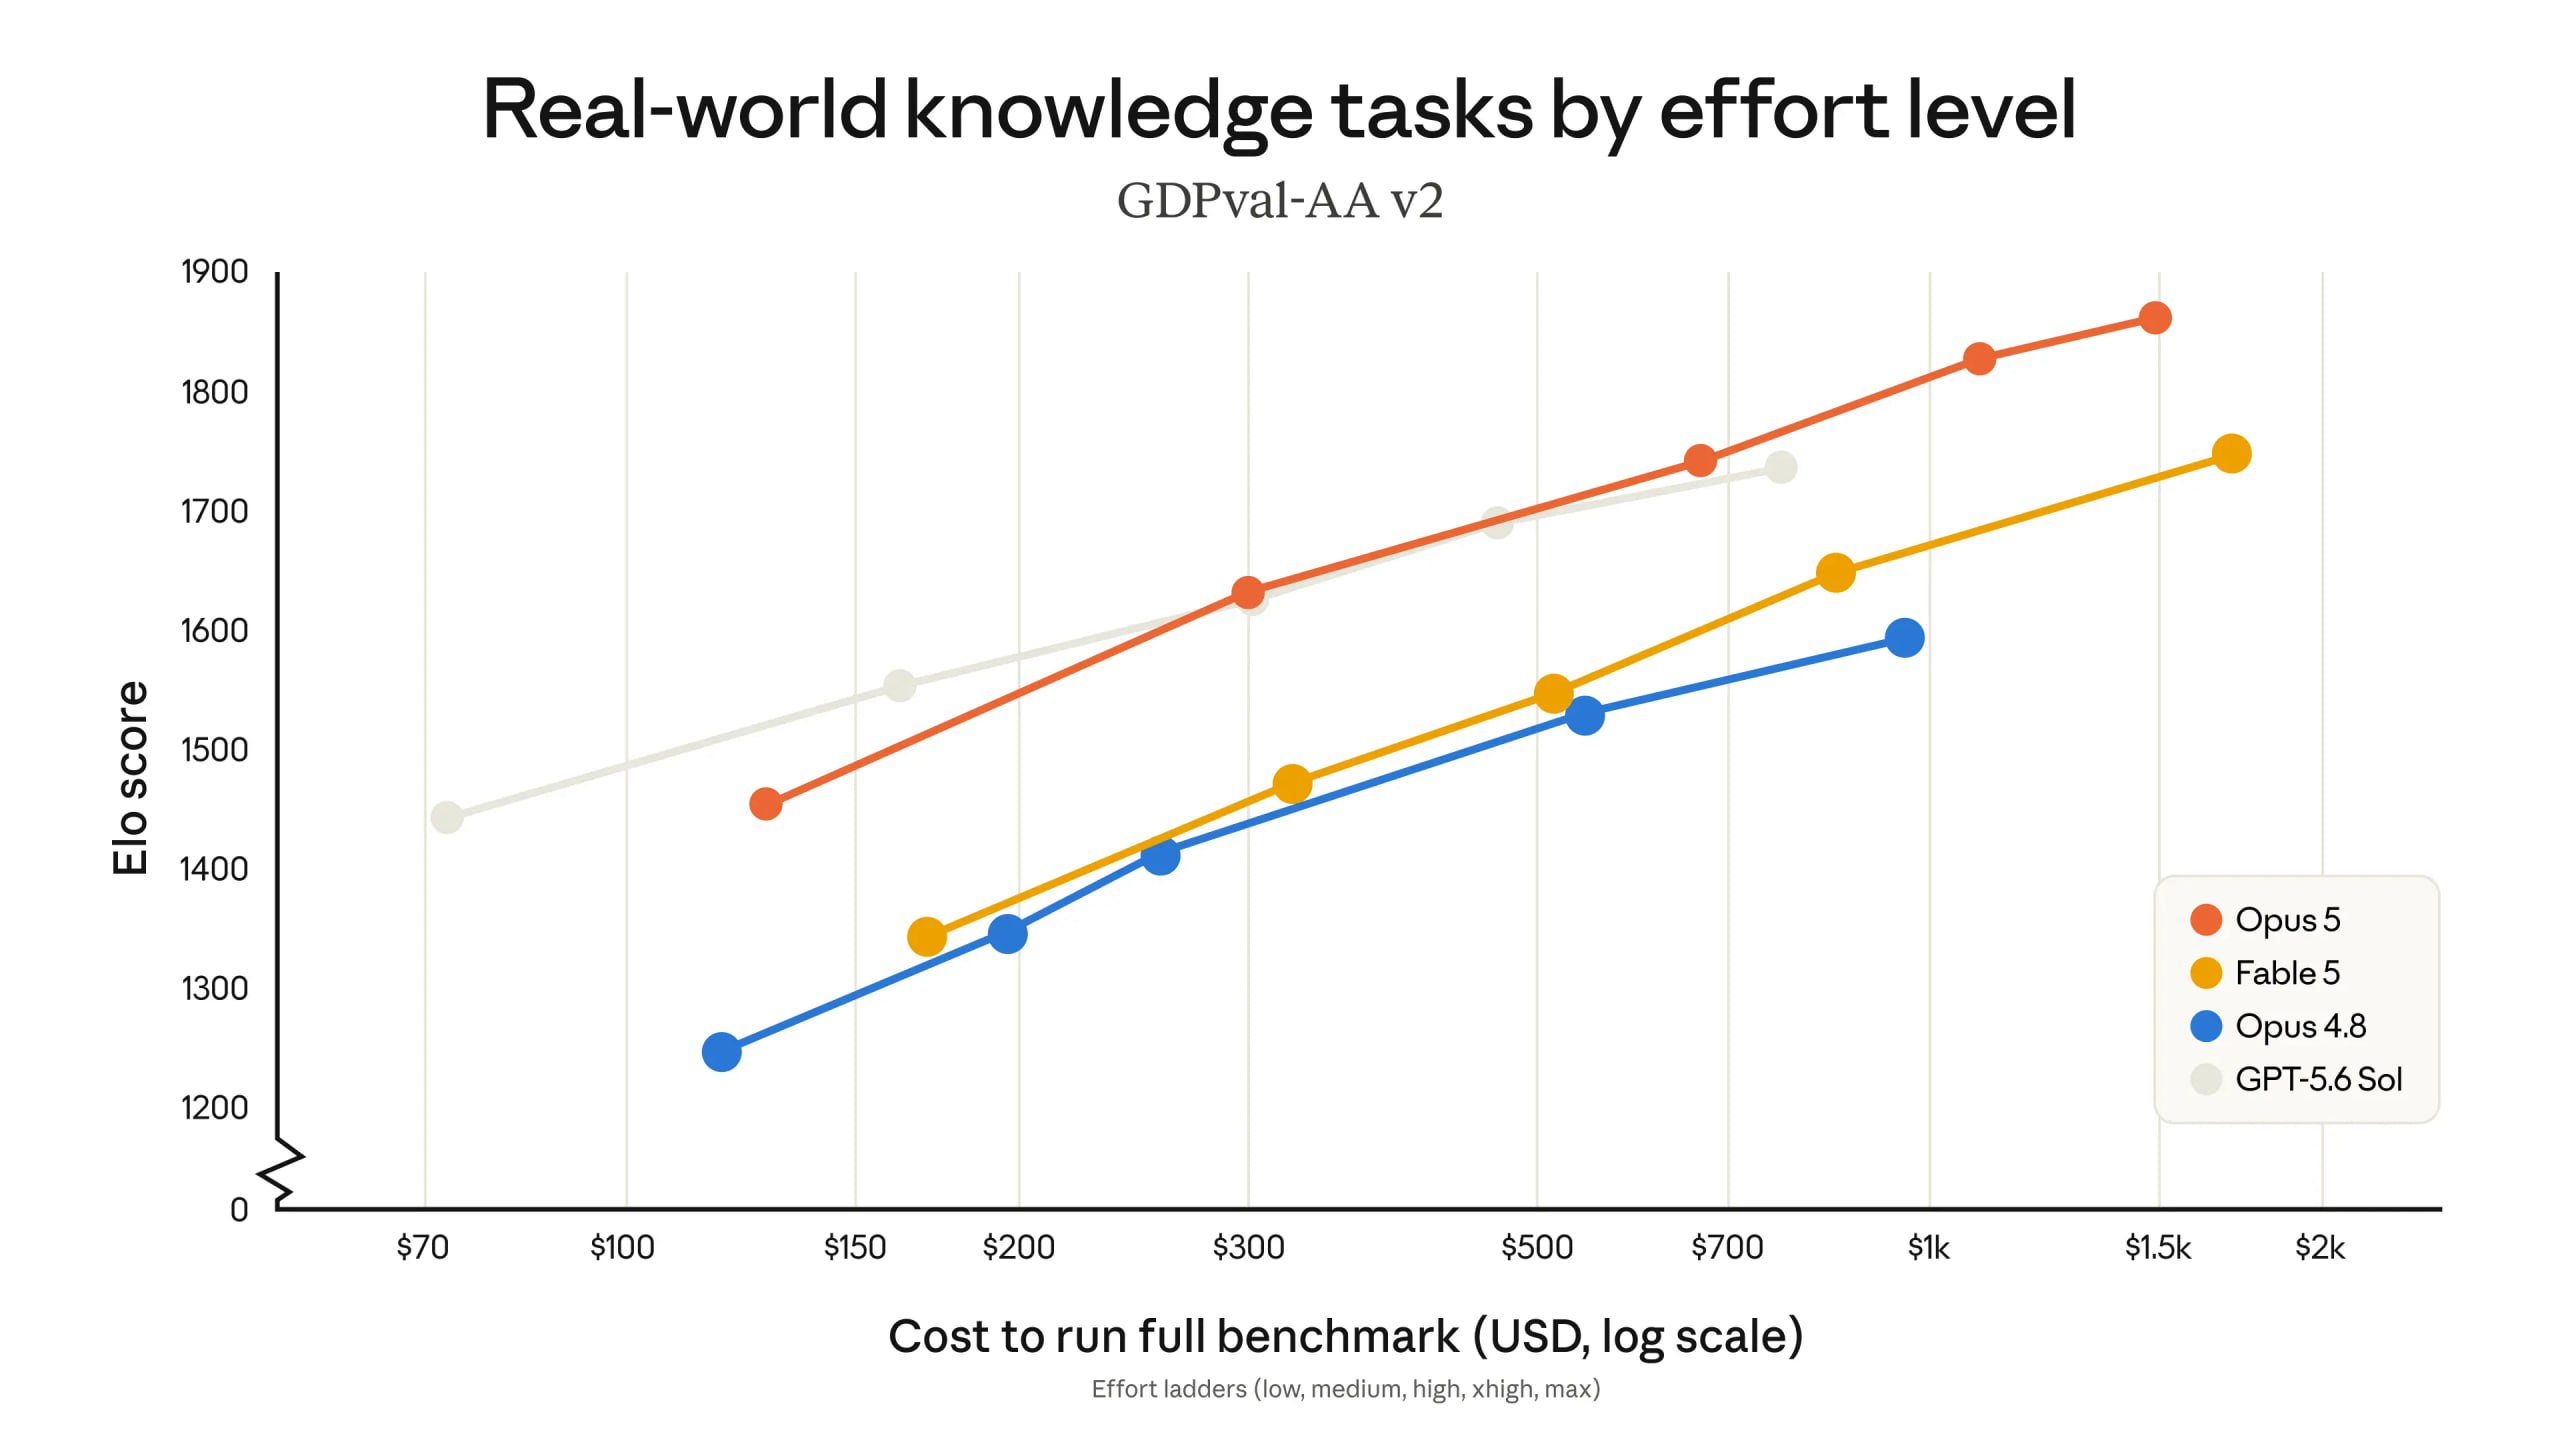
График "Real-world knowledge tasks by effort level" по бенчмарку GDPval-AA v2 показывает, что Opus 5 (красная линия) имеет наивысший Elo-балл при различных затратах на выполнение полного бенчмарка, превосходя Fable 5, Opus 4.8 и GPT-5.6 Sol.
График "Agentic computer use performance by effort level" по бенчмарку OSWorld 2.0 показывает, что Opus 5 (красная линия) достигает наивысшего балла (около 70%) при затратах около 20 USD на задачу, опережая Fable 5, Opus 4.8 и GPT-5.6 Sol.
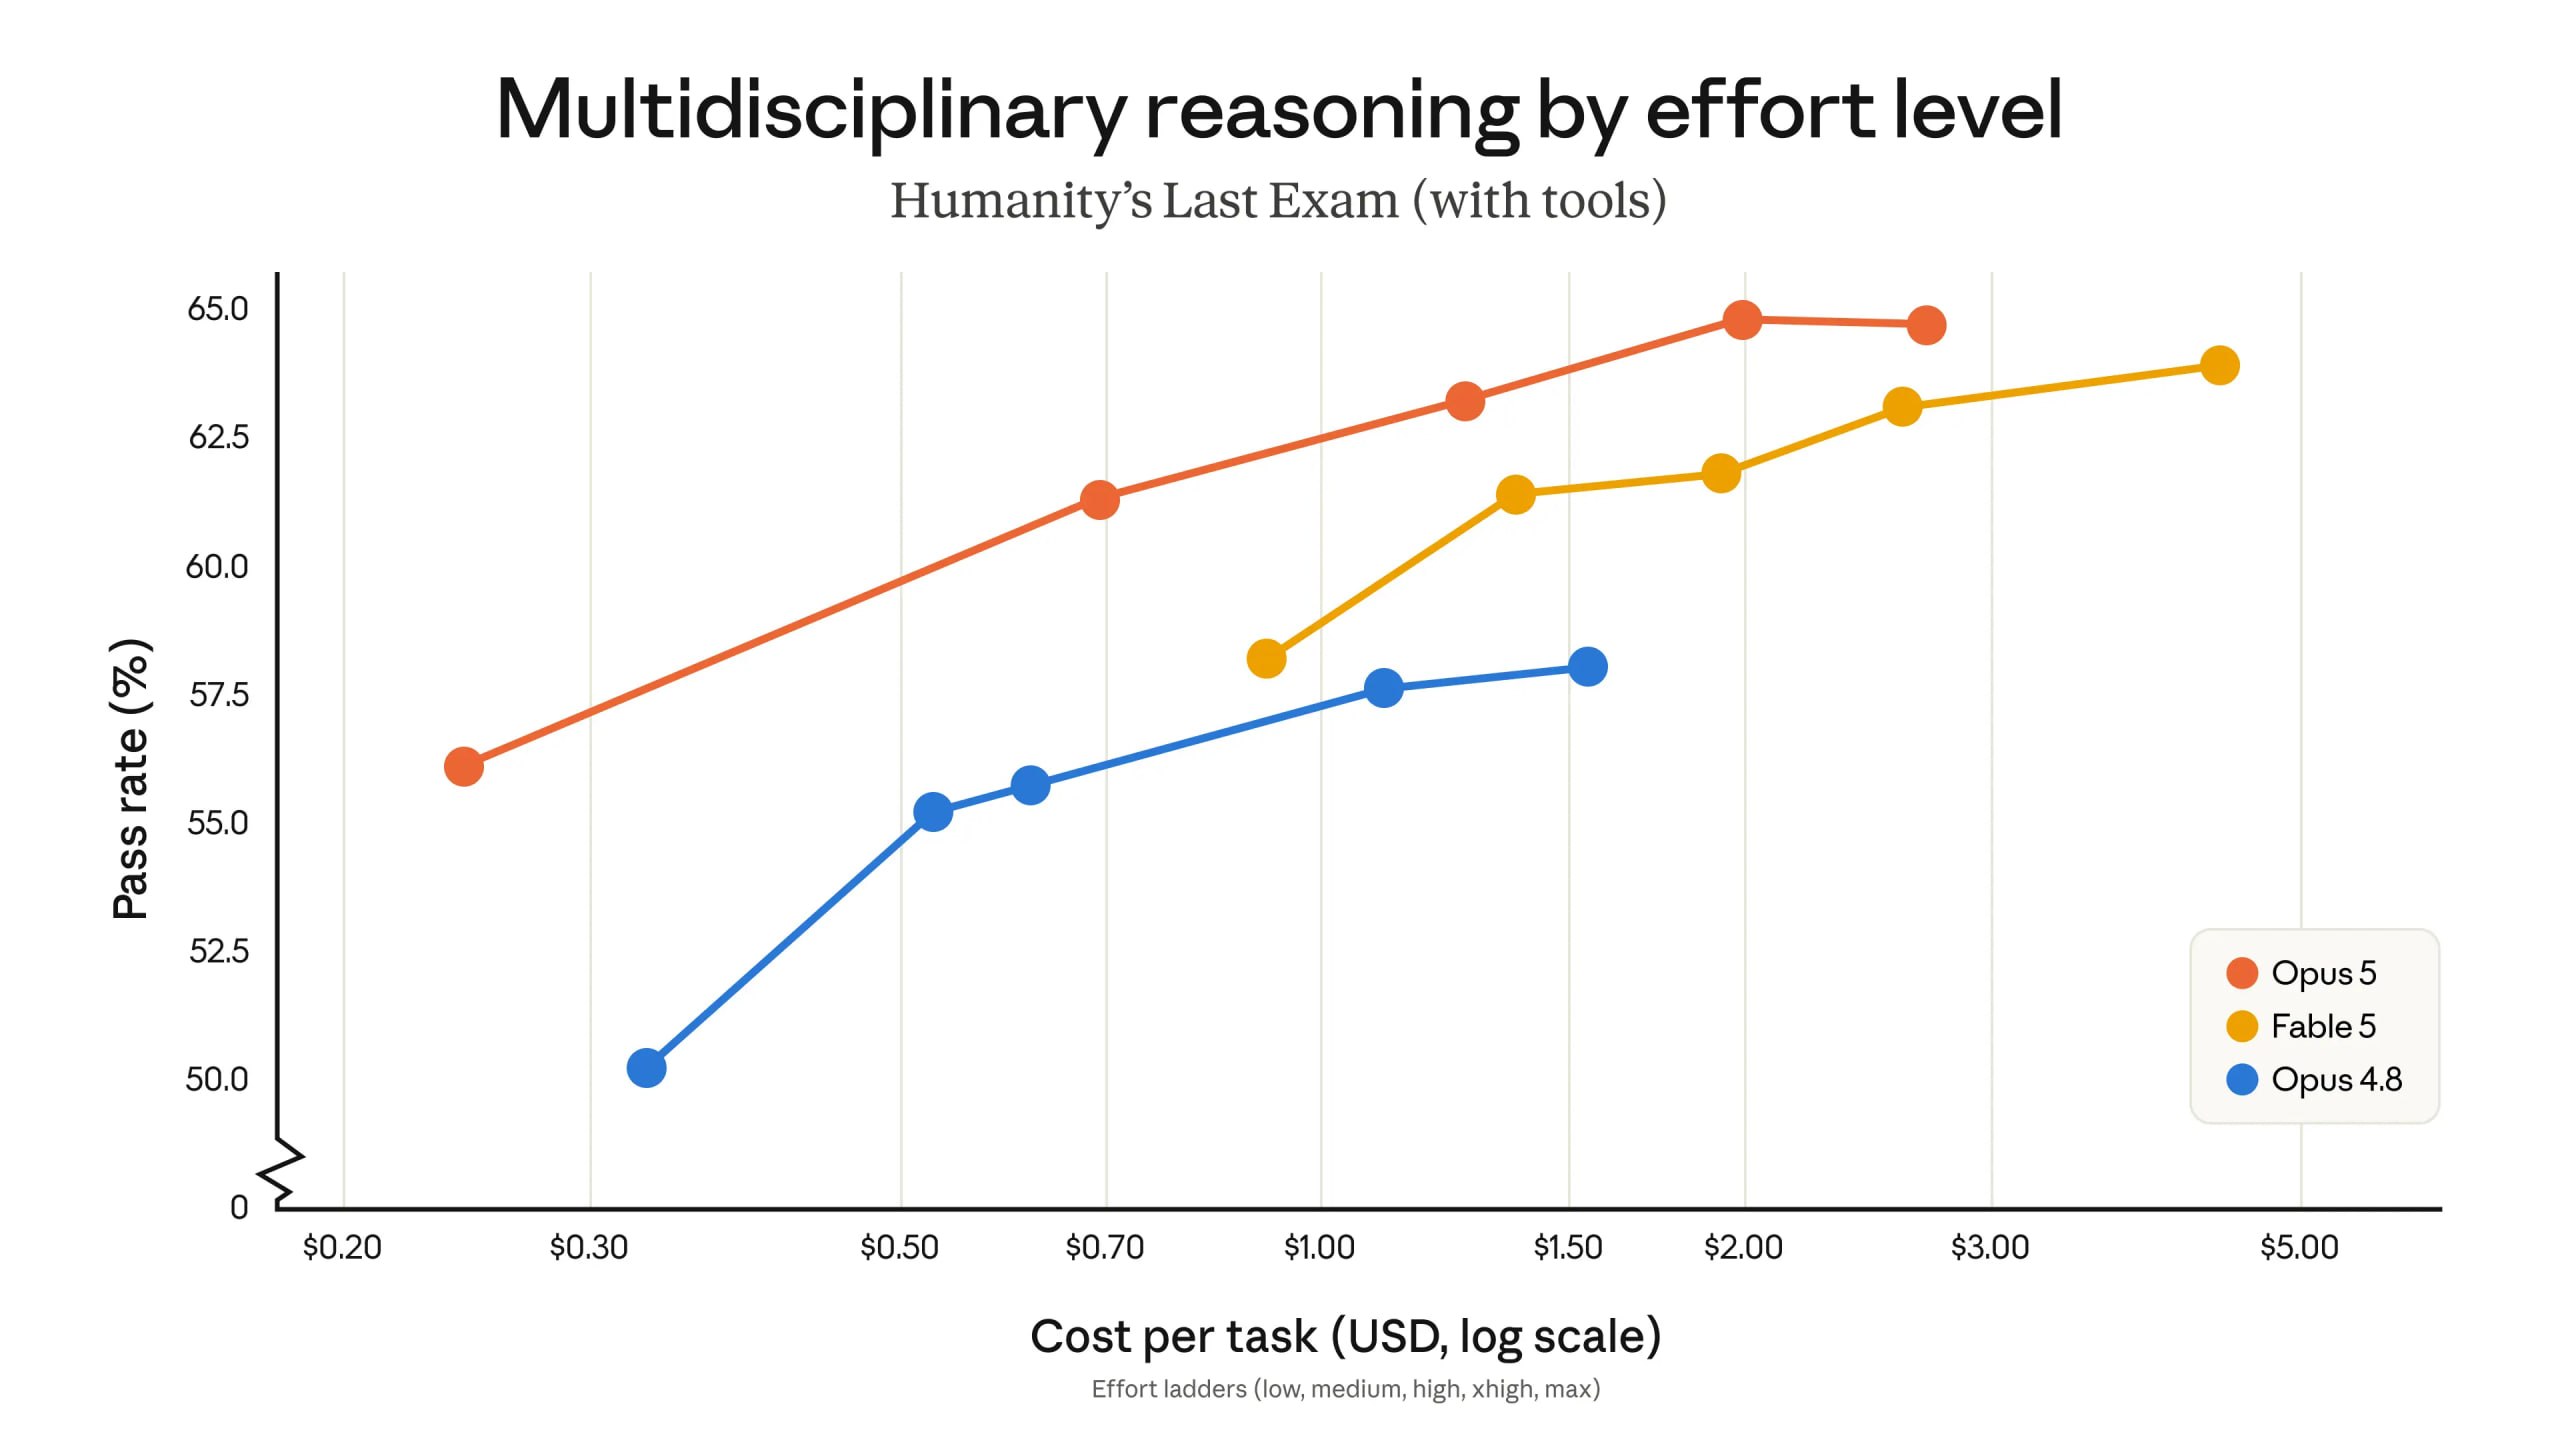
График "Multidisciplinary reasoning by effort level" по бенчмарку Humanity's Last Exam (with tools) показывает, что Opus 5 (красная линия) имеет наивысший процент прохождения (до 65%) при затратах на задачу до 3 USD, превосходя Fable 5 и Opus 4.8.
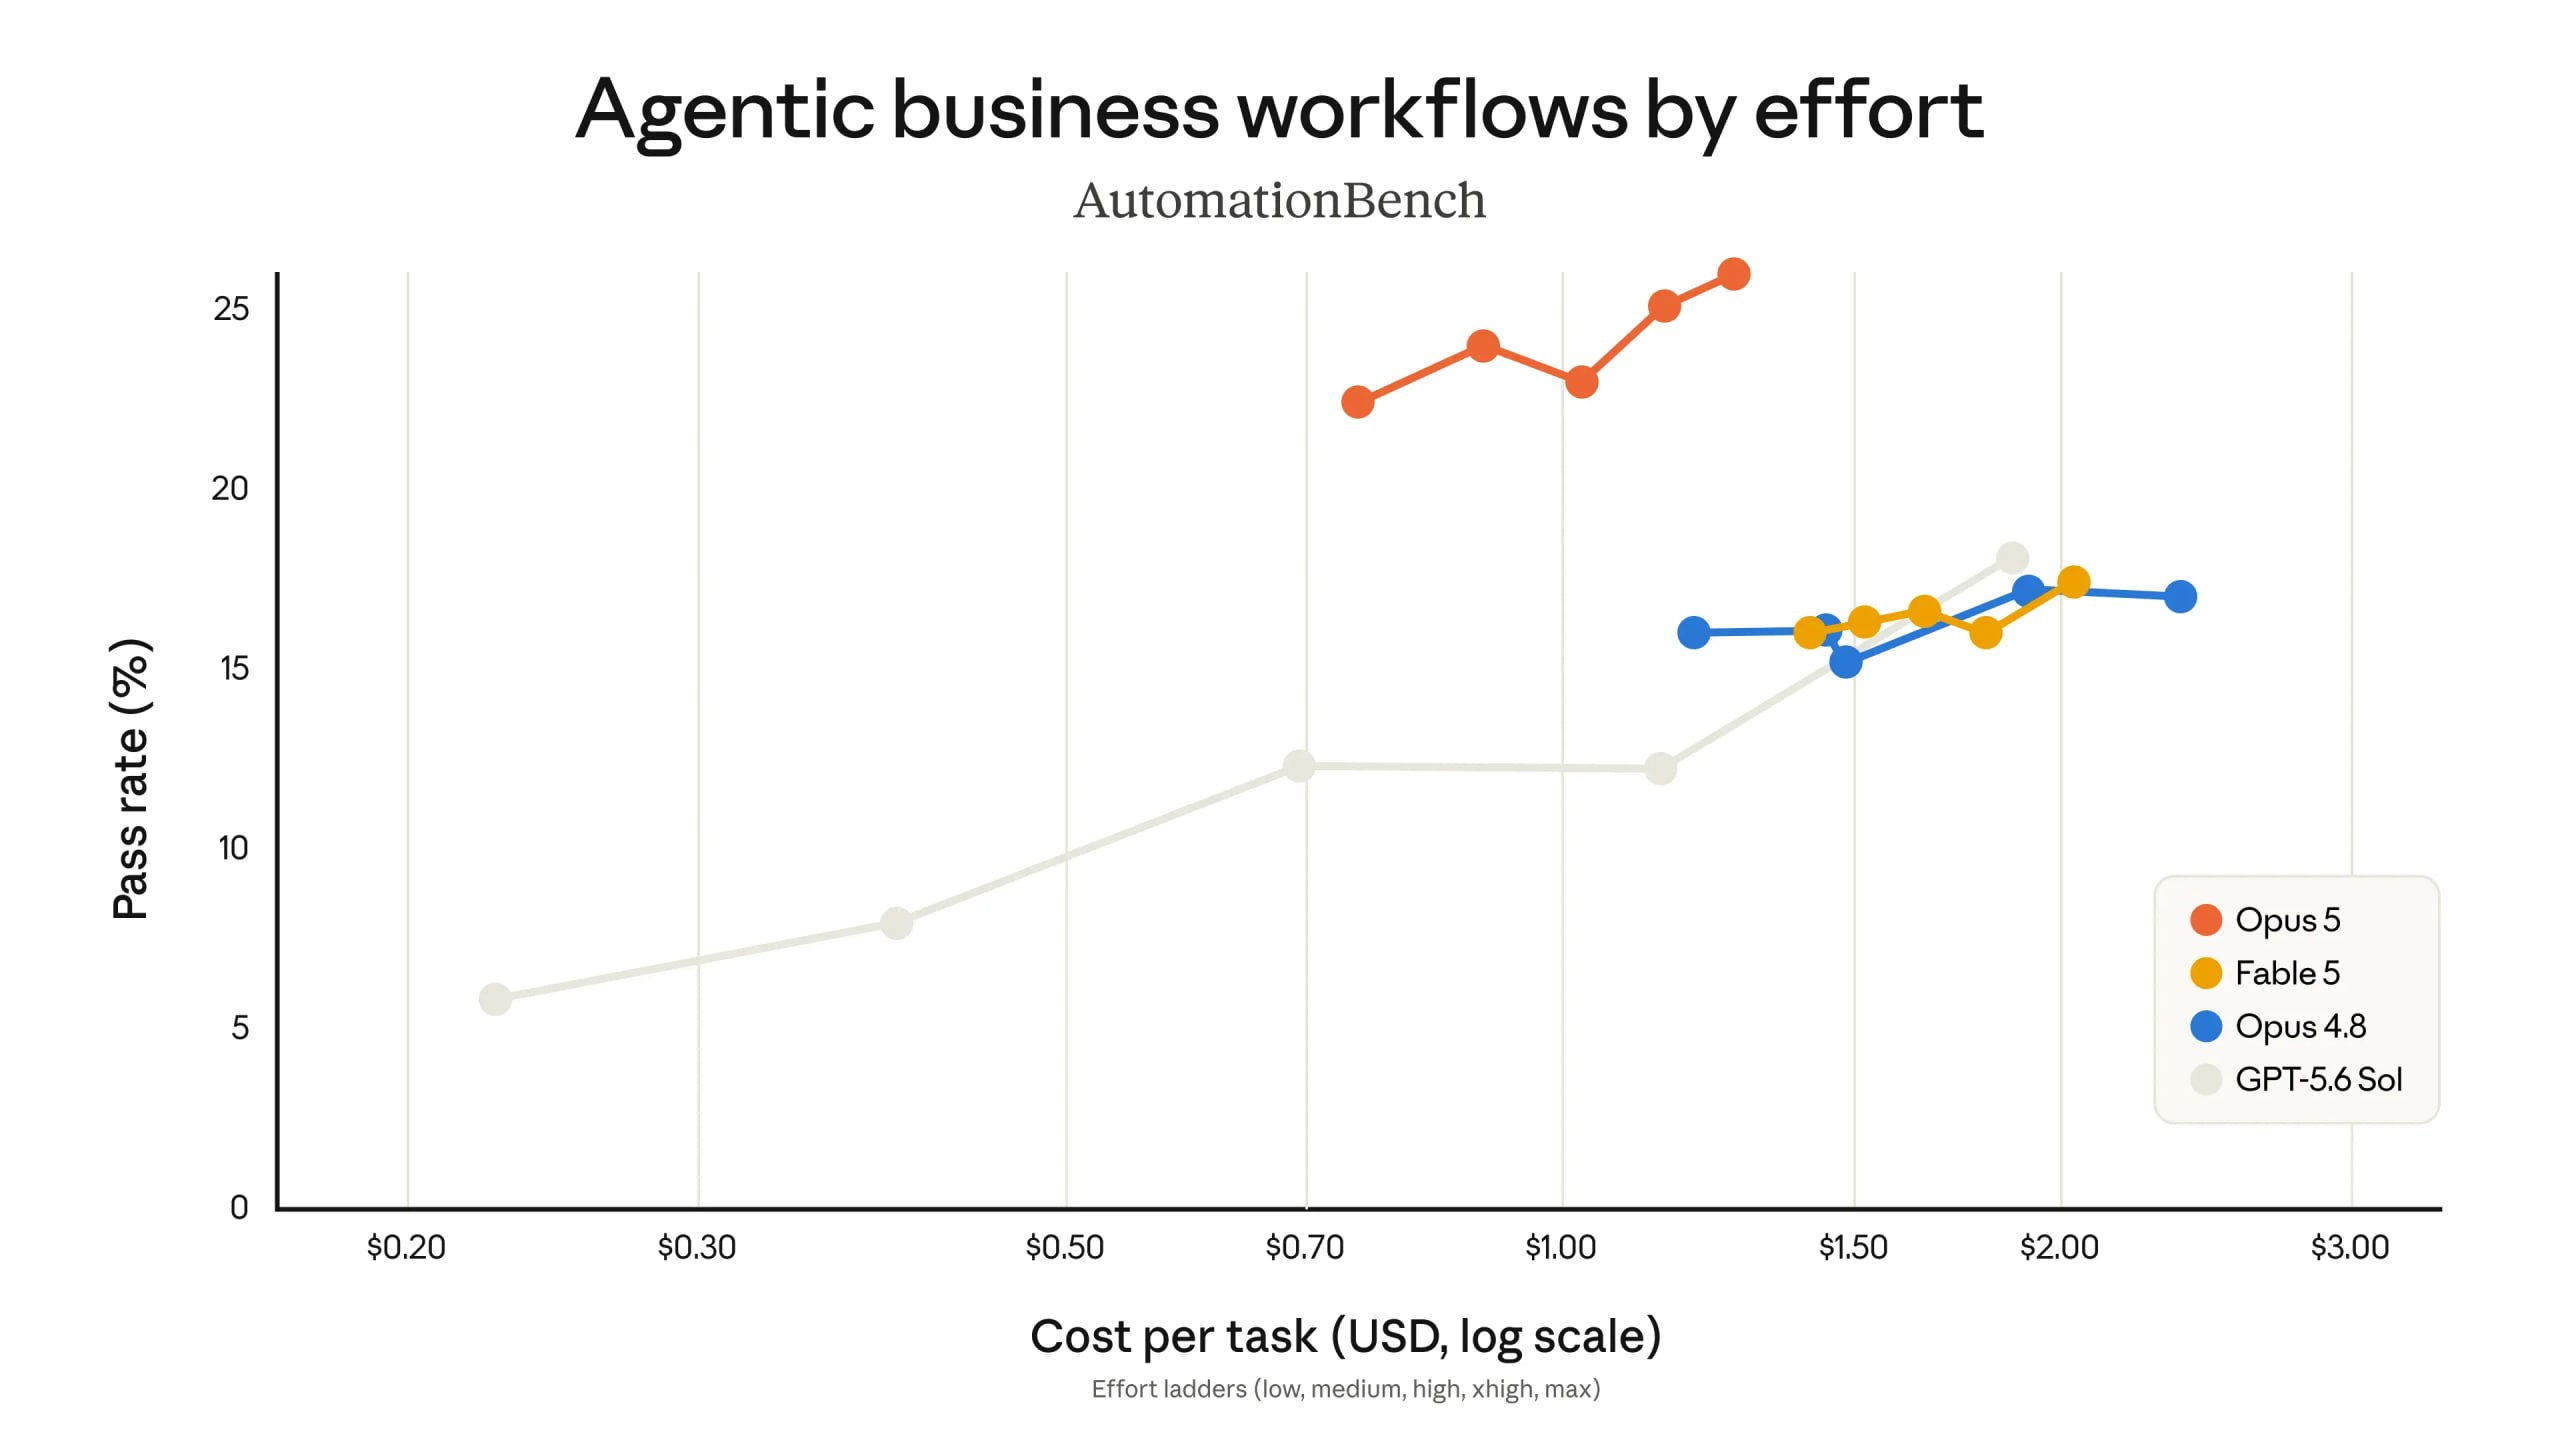
График "Agentic business workflows by effort" по бенчмарку AutomationBench показывает, что Opus 5 (красная линия) достигает наивысшего процента прохождения (до 25%) при затратах на задачу около 1.2 USD, значительно опережая другие модели.
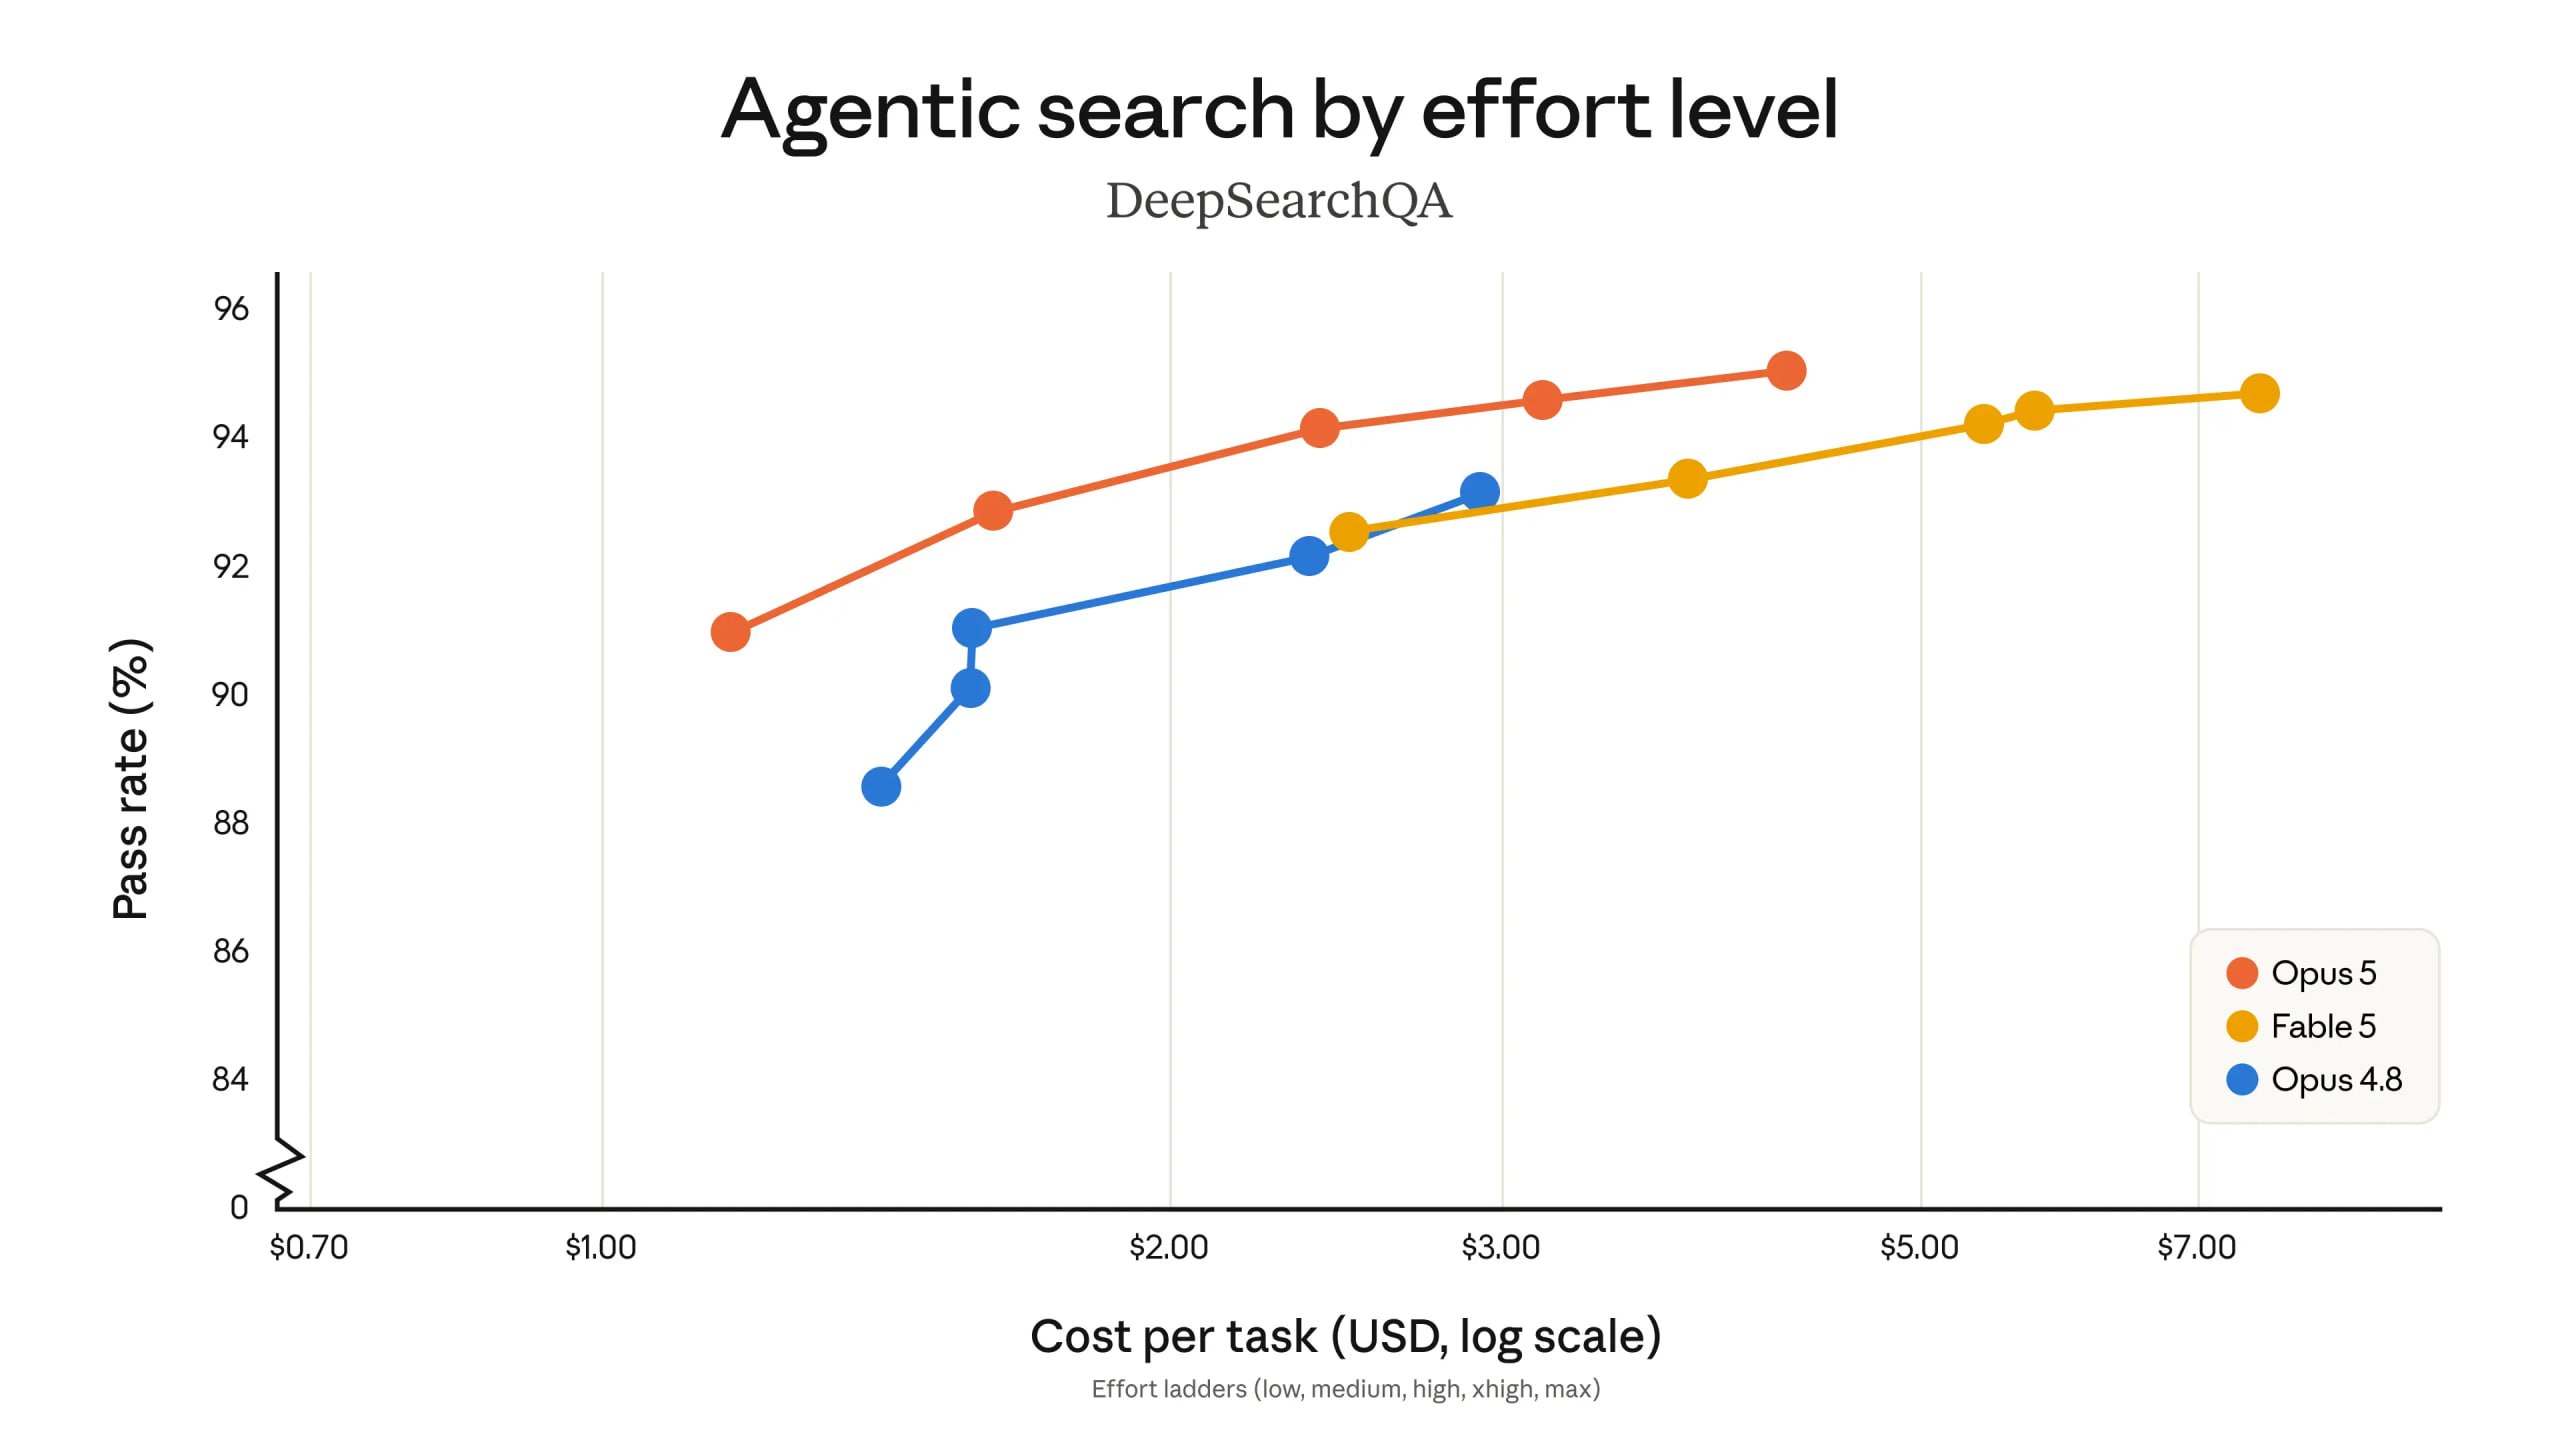
График "Agentic search by effort level" по бенчмарку DeepSearchQA показывает, что Opus 5 (красная линия) имеет наивысший процент прохождения (до 95%) при затратах на задачу около 3.5 USD, превосходя Fable 5 и Opus 4.8.
ClaudeFable 5AnthropicClaude
English versionMarkdown

Разборы

По теме